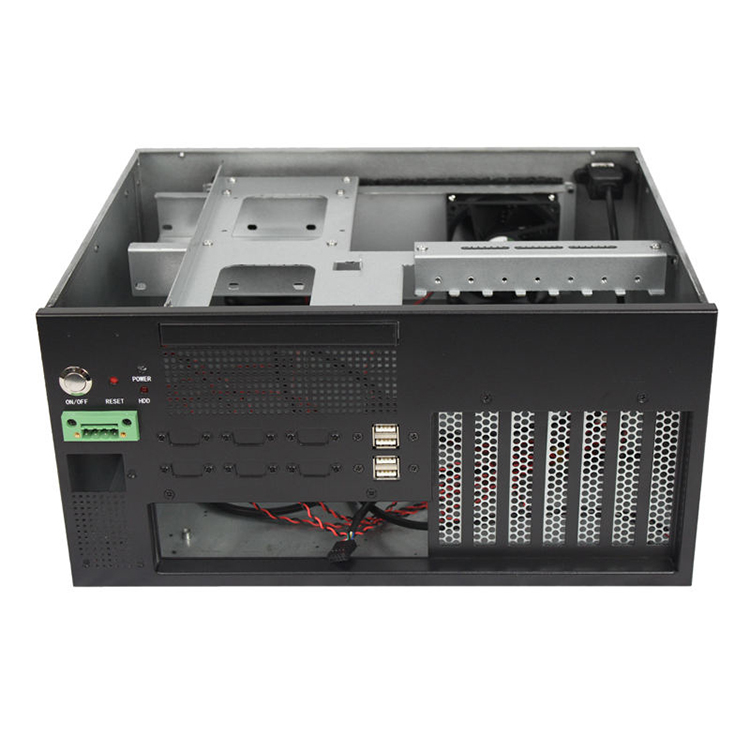
ぜひ弊社まで サーバーシャーシ エンジニアおよび営業チーム
チャンネル登録者数24,000人
お客様の用途、シャーシの種類、ラックの高さ、マザーボード、GPU、ドライブベイ、電源、冷却システム、I/O、および注文数量をお知らせください。当社のエンジニアおよび営業チームが、お客様のプロジェクトに適した標準モデルまたはOEM/ODM構成をご提案いたします。.
AIハードウェアは、「高密度」という言葉の意味を一変させた。“
数年前、サーバー筐体の設計プロジェクトは、マザーボードの寸法、ドライブベイ、PCIeスロット、PSUの形式、ラックの高さといった要素から始まることが多かった。これらの要素は今でも重要である。 しかし、AIコンピューティングプロジェクトには、さらに別の難しさが加わります。それは、小さなスペースに詰め込まれた複数の高電力アクセラレータ、極めて高い電流需要、重量のあるカード、高密度なケーブル束、設置スペースに制約のあるヒートシンク、高速ネットワーク、そしてわずか数ミリのスペースを奪い合う冷却ハードウェアといった要素です。.
それによって、仕事の内容が根本から変わってしまいます。.
問題はもはや単に、, “「このシャーシにGPUを8枚収めることはできますか?」”
もっと適切な質問は、次の通りです:
“「このシャーシにシステム全体を収め、熱的、電気的、構造的、あるいは保守上の問題を引き起こすことなく、持続的なワークロード下で稼働させ続けることは可能でしょうか?」”
それが、本格的な製品に込められたデザイン哲学なのです。 カスタムAIサーバーシャーシ.
現在のラックスケールAIプラットフォームは、エンクロージャーの設計にもっと注力すべき理由を示している。.
NVIDIAのGB300 NVL72リファレンスアーキテクチャは、72個のBlackwell Ultra GPUと36個のGrace CPUを統合しています。NVIDIAによると、このラックは水冷式で、8つの33 kW電源シェルフを採用しており、必要となる電力は フルラックで最大142 kW.
それは、一般的なサーバールームの密度とは異なります。.
NVIDIAの別の「Mission Control」電源管理に関するドキュメントには、設計上のラック消費電力が GB200 NVL72は120 kW、GB300 NVL72は135 kW, 、ノードあたりの最大電力予算はそれぞれ約6.7 kWおよび7.5 kWです。これらの数値は電力予算の観点から提示されているため、あらゆるラックの最大仕様と互換性があるものとして扱うべきではありませんが、これらは同じ技術的現実を示しています。すなわち、現代のAIコンピューティングは、極めて小さな物理的フットプリントの中で膨大な電力を消費しうるということです。.
| 基準点 | 掲載図 | エンクロージャーの設計にとっての意味 |
|---|---|---|
| NVIDIA GB300 NVL72 | 72個のGPU + 36個のGrace CPU | 極めて高密度な演算、ネットワーク、電源、および冷却液の配線 |
| GB300 NVL72 のフルラック要件 | 最大142 kW | 熱設計と電源設計は、後回しにすることはできない |
| NVIDIA PRSの例におけるGB300対応ラックの設計電力 | 135 kW | 配電とヘッドルームについては、システムレベルで検討する必要があります |
| PRSの例におけるGB300の最大ノード電力 | 7.5 kW | 個々のコンピューティングトレイは、かなりの熱負荷を処理できる |
| IEAによるサーバー関連の電力消費量の急増 | ベースケースでは年間約30% | 高密度高速計算は、今後さらに普及していくと見られる |
大まかな傾向も同様の方向を示している。国際エネルギー機関(IEA)の「エネルギーとAI」に関する分析によると、世界のデータセンターの電力消費量は約 2030年までに945 TWh ベースケースでは。主にAIの導入を背景とした、高速化されたサーバーによる電力消費量は、およそ 年間30%, 、一方、従来のサーバーでは約9%です。.
筐体設計者やOEMバイヤーにとっては、それが重要なポイントとなります。.
ハードウェアの高速化が進むにつれ、電力密度、GPUの負荷、冷却能力、ケーブル管理、および保守アクセスが、最優先の機械的要件となるプロジェクトが増えてきています。.
カスタム筐体プロジェクトを頓挫させる最も早い方法の一つは、コンピューティングアーキテクチャが安定する前にCAD作業を開始することです。.
やめておいたほうがいい。.
シャーシのジオメトリが確定する前に、エンジニアリングチームは、想定されるワークロードと、システム内に搭載される予定の主要コンポーネントを把握しておく必要があります。.
少なくとも、以下の項目をロックダウンしてください:
アン AIサーバー筐体 この統合パッケージを基に設計を行う必要があります。後で一部を変更すると、設計の他の部分にも連鎖的な影響が及ぶ可能性があります。.
GPUを交換する?
コネクタの位置が変わる場合があります。.
電源ユニットを交換する?
ケーブルの束が変化します。.
もう1枚ネットワークカードを追加する?
ここで、ライザーの形状が変わります。.
ファンの厚さを増やす?
突然、GPUの電源ケーブルを曲げられる適切な場所がなくなってしまいました。.
ミリメートルという単位はあっという間に積み重なっていく。.
これは当たり前のように聞こえるかもしれませんが、大きな損失を招くミスの原因となります。.
シャーシに収まるサイズのGPUだからといって、そのGPUがシャーシ内で正常に動作するとは限らない。.
を評価する際には、 GPUサーバーシャーシ, 、カードの公称寸法だけでなく、実際の設置スペースも確認する必要があります。.
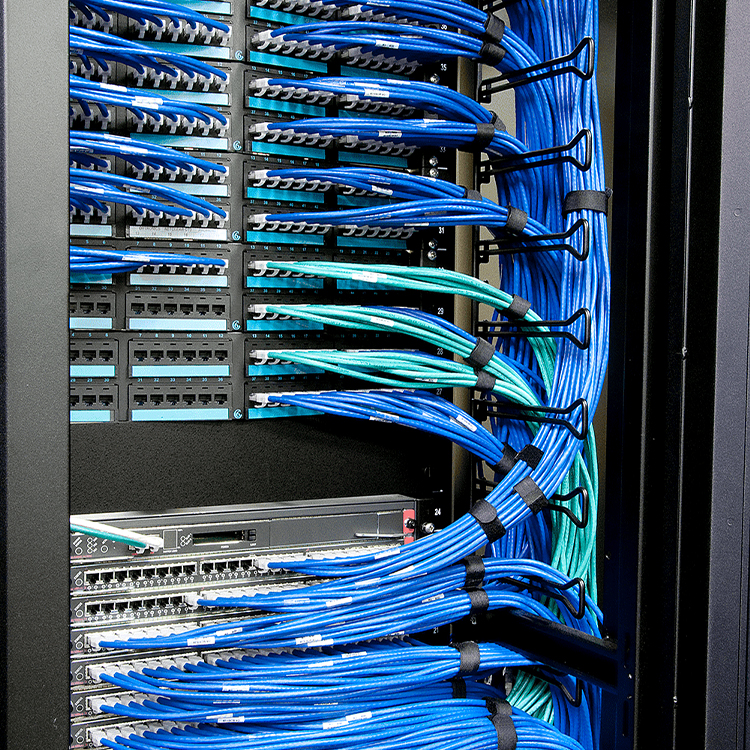
これには、カード本体、ヒートシンク、電源コネクタ、コネクタの曲げ半径、隣接するカードとのクリアランス、マザーボードのスロット位置、固定用金具、ライザーの位置、ファンの壁面、配線、および技術者がカードを取り外す際の方向などが含まれます。.
大型加速器には、もう一つの問題があります。それは重力です。.
長いカードは、PCIe接続部や背面取り付け部に大きな負荷をかける可能性があります。輸送中の振動によって、その影響はさらに悪化する可能性があります。実験台の静止状態で動作に問題のないGPUであっても、国際輸送、ラックへの設置、繰り返されるメンテナンス作業、あるいは高速ファンによる振動などを経ると、動作が全く異なってくる場合があります。.
高密度システムの場合、GPUの固定機構はシャーシ構造の一部として組み込まれるべきであり、出荷の2日前に誰かが思い出すような付属品であってはならない。.
熱は、CAD図面がどれほど見栄えが良くても気にしない。.
高密度なサーバーは、機械的には完璧でも、熱的には最悪の場合がある。.
空冷システムの場合、シャーシには意図的な気流経路が必要です。空気は、ハードウェアが想定している場所から流入し、熱抵抗の高い部品を通過した後、高温領域を繰り返し循環することなく筐体外へ排出される必要があります。.
それは簡単そうですね。.
そうじゃない。.
ケーブルが邪魔になる。ドライブケージが邪魔になる。PSUの筐体が邪魔になる。背の高いDIMM、ライザー、構造用ビーム、ラジエーターブラケット、コネクタ、フィルター、バックプレーン、さらには配置の悪い板金フランジでさえ、気流経路の圧力を奪ってしまうことがある。.
A 高密度AIラック したがって、ファンの位置だけを考慮して設計することはできない。.
“「6人のファン」という情報だけでは、ほとんど何もわからない。.
ファンの寸法、ファン特性曲線、静圧、圧力損失、吸気温度、排気経路、制御戦略、構成要素のインピーダンス、および1台のファンが停止した際の挙動について知りたいです。.
それらは有益な質問ですね。.
| 設計係数 | 空冷 | 水冷 |
|---|---|---|
| 機械的な複雑さ | より低い | より高い |
| シャーシの気流への依存性 | 非常に高い | 水冷式コンポーネント向けに小型化 |
| 施設の統合 | たいていはもっと単純です | CDU、マニホールド、ホース、施設への給水接続が必要になる場合があります |
| リーク管理要件 | 冷却ループなし | はい |
| サービス手順 | ほとんどの技術者にとっておなじみの | 冷却液を考慮した整備手順が必要 |
| 熱密度の上昇に伴う適合性 | ますます難しくなっている | 多くの場合、より実用的である |
| 内部空間コンペ | ファンとダクト | 冷却プレート、配管、マニホールド、コネクタ |
| 障害対策計画 | ファンの冗長性と気流の損失 | ポンプ、CDU、漏洩、流量、および施設ループのシナリオ |
~への引っ越し 水冷式サーバーシャーシ 機械設計の作業がなくなるわけではありません。作業の内容が変わるのです。.
さて、ホースの経路が重要になってきます。.
クイックディスコネクトによるアクセスは重要です。.
漏れの検知は重要です。.
最小曲げ半径は重要です。.
マニフォールドの位置は重要です。.
技術者は、関係のないハードウェアを取り外したり、電子機器を水に浸したりすることなく、ループの接続を解除・再接続するための十分なスペースを必要とします。.
NVIDIAのGB300 NVL72アーキテクチャ自体は、ラックレベルおよびトレイレベルのリーク検出機能と液体冷却を併用しており、これは、冷却液の管理が単なるGPUにボルトで固定されたコールドプレートではなく、システムアーキテクチャの一部であることを改めて認識させてくれる。.
配電は、しばしば電気工学のテーマとして扱われる。.
密閉された空間の中では、これもまた非常に機械的な問題となります。.
大電流の電源システムでは、コネクタの大型化、ケーブル数の増加、曲げ半径の厳格な制限、バスバーに関する追加の考慮事項、コネクタ温度の上昇、そして「重要な」コンポーネントの設置後に残されたスペースを通って配線を敷設する自由度の低下といった課題が生じます。.
電力アーキテクチャには物理的な領域が必要です。.
予約してください。.
複数のアクセラレータを前提に設計されたシャーシには、冗長化された電源装置、大電流の配電、アクセスしやすいコネクタ、安全なケーブルの分離、電源装置(PSU)周辺の通気性、およびサーバーを分解せずに故障したモジュールを交換できるスペースが必要となる場合があります。.
そこで 高密度サーバーシャーシ 紙面上ではコンポーネントのリストが完全に互換性があるように見えても、問題が生じる可能性があります。.
すべてがぴったりと収まる。.
使えるものは何一つない。.
最近、業界の議論を振り返っていたところ、高密度ラックの冷却に関するr/sysadminの古いスレッドに出くわし、それが頭から離れなくなりました。.
スレッドの投稿者は、複数のNVIDIA DGXシステムとストレージ機器を所有しており、1つのラックに約30~40 kWを収める方法を模索していました。ある参加者は、キャビネットを最大約36 kWで稼働させていることを説明し、冷却装置が故障した場合の余裕時間は極めてわずかで、その特定の導入環境における多くのシステムでは、熱シャットダウンに至るまで約20秒しかないと述べました。 スレッドに参加した他のエンジニアたちも、冷却システムの可用性、施設の電力供給能力、緊急シャットダウン、配管、保守の専門知識、そして1つのキャビネットにこれほど多くの熱を集中させることによって生じるリスクなど、同様の懸念を繰り返し指摘していました。.
その議論が私の興味を引いたのは、買い手がカスタムAIプロジェクトを始める際、時に次のような魅力的な質問を投げかけることがあるからだ。
このスペースに、どれだけの演算能力を詰め込むことができるでしょうか?
最初の質問が間違っている。.
より良いのは次の通りです:
実際の施設環境下において、このエンクロージャーは、継続的かつ安全に、そしてメンテナンス可能な状態で、どの程度の演算処理能力に対応できるでしょうか?
シャーシはCAD画面上では見栄えが素晴らしいものです。すべてのコンポーネントがぴったりと収まり、すべてのラックユニットが埋まっています。.
そして、仕事が始まる。.
ファン用スロープ。.
ケーブルの温度が上昇する。.
GPUの排熱が別の熱源と衝突する。.
あるコンポーネントがスロットリングを行う。.
技術者がカードを取り外そうとしたところ、3本のケーブルとマニホールドが邪魔になっていることに気づいた。.
それは高密度工学とは言えません。.
これが高密度パッケージングです。.
違いがあります。.
カスタムAI筐体において、コンポーネントの最大配置密度は、多くの場合、望ましくない設計目標となります。.
そう、私が言ったんだ。.
“「4Uに8基のGPU」というのは、比較表では非常に魅力的に見えます。.
“「ラックユニットあたりの最大演算能力」という表現は、調達プレゼンテーションでは非常に印象的に映ります。.
しかし、GPUを1基追加したことで、空気の流れが悪くなったり、サーマルスロットリングが発生したり、コネクタに手が届かなくなったり、電源配線が過負荷になったり、現場での修理が困難になったり、あるいは実験室のような理想的な環境条件から逸脱した場合に余裕がまったくなくなったりするのであれば、そのGPUは意味をなさなくなります。.
優勝した囲いが、必ずしも最も小さいものとは限りません。.
多くのプロジェクトにおいて、私は、完成したシステムの運用が極めて困難になってしまうような「高密度化競争」に勝つことよりも、予測可能な気流、堅牢なGPUサポート、整然とした電源配線、合理的なケーブル配線、メンテナンスしやすいファン、そして技術者が作業するのに十分なスペースを備えた、やや大きめのシャーシを構築する方を好みます。.
最適な高密度エンクロージャーとは、そのワークロードに耐えうるものである。.
テトリスで勝つ方ではない。.
CADのレビュー中に、簡単な質問をしてみてください:
何が最初に故障するのか、そしてそれをどのように交換すればよいのか?
次に、その答えを実際に再現してみてください。.
技術者は、GPUを取り外さずにファンを交換できますか?
PSUは背面から取り外せますか?
冷却液ホースを動かさずに、ネットワークアダプタにアクセスすることは可能ですか?
関係のないケーブルを外さずに、GPUを縦方向または横方向に取り外すことはできますか?
サーバー全体を取り外さずに、フロントパネルのメンテナンスを行うことは可能ですか?
水漏れしている継手にはすぐに手が届くか?
起動ドライブに不具合が生じた場合、演算セクションに触れることなくそのドライブを交換することは可能ですか?
これらの質問は、決して華やかなものではありません。.
それにより、お金を節約できます。.
50台、100台、あるいは500台の機器を組み立てるシステムインテグレーターにとって、1台あたり数分の追加サービス時間は、実質的な運用コストとなります。また、アクセス順序が不適切だと、技術者が別の問題の修理中に、付近にあるケーブル、コネクタ、カード、あるいは配管を損傷してしまう可能性も高まります。.
だからこそ、 カスタムラックマウント筐体 組み立てだけでなく、分解も考慮して設計されるべきである。.
生産エンジニアはそれを一度だけ組み立てます。.
お客様は、この製品を何年も使い続けるかもしれません。.
AIサーバーは負荷が高い。.
時には非常に重いこともあります。.
シャーシは、組み立て、輸送、ラックへの設置、通常の稼働、およびメンテナンスの各段階で、その負荷に対応しなければなりません。長いGPUカード、複数の電源ユニット、大型のマザーボード、銅製のヒートシンク、ラジエーター、マニホールド、高密度ストレージなどは、いずれも重心をずらす要因となります。.
チェックする:
ブラケットは、単独で見ると取るに足らないものに見えるかもしれません。.
そのわずかなたわみを、長くて重いカード全体に拡大し、輸送中の振動を加味した上で、生産ロット全体にわたって繰り返してみてください。.
今こそ重要なのだ。.
試作モデルとは、単にネジ穴の位置が合っているかを確認するための金属製のサンプルに過ぎないわけではありません。.
積極的に活用しましょう。.
実際のマザーボードを取り付けます。.
実際のGPUを取り付けます。.
実稼働環境と同等の電源ケーブルを使用してください。.
完成したサーバーに搭載されるのと同じライザー、ドライブ、ネットワークアダプタ、ファン、ラジエーター、チューブ、PSU、レール、およびフロントパネルアセンブリを取り付けてください。.
次に、その厄介な条件をテストしてください。.
コンポーネントの取り付け、カードの固定状態、ケーブルの配線、コネクタへのアクセス、筐体の剛性、レールの嵌合状態、カバーの密着度、およびメンテナンス手順を確認してください。.
代表的なワークロードを実行する。想定される周囲環境条件下において、吸気温度、排気温度、コンポーネントの温度、ファンの動作、高温箇所、および性能を測定する。.
PSUの負荷状況、冗長性の動作、ケーブルの温度、コネクタの温度、電力分配、および起動時の動作を確認してください。.
あるファンが停止すると、どうなるのでしょうか?
冷却ポンプや施設ループに不具合が生じた場合、どうなるのでしょうか?
1台のPSUが故障するとどうなるのでしょうか?
フィルターが部分的に詰まってしまった場合はどうなりますか?
周囲の温度が上がると、どうなるのでしょうか?
熱試験に合格したにもかかわらず、出荷時にGPUが筐体内でずれてしまっているマシンは、やはり設計上の失敗である。.
量産出荷に先立ち、梱包、保持性、耐振動性、ブラケット、締結部品、および重量部品の支持について試験を行う。.
不十分な見積依頼書は、憶測を招く。.
仮定は修正を生む。.
修正には時間がかかります。.
カスタムAIシャーシのプロジェクトについては、単なる金属製の空殻の見積もりを出すのではなく、システム全体のアーキテクチャを評価できるだけの十分な情報をサプライヤーに提供してください。.
有用な見積依頼書(RFQ)の資料一式には、以下の内容が含まれている必要があります:
| 見積依頼(RFQ)の入力 | 提出すべき情報 |
|---|---|
| フォームファクター | 対象物の高さ、幅、奥行き |
| マザーボード | モデル、寸法、図面、取り付け位置 |
| GPU | 正確なモデル名、数量、寸法、スロット幅、電力 |
| CPU | プラットフォーム、数量、クーラー |
| メモリー | DIMMの構成およびクリアランス要件 |
| ストレージ | ドライブの種類、数量、ホットスワップの要件 |
| ネットワーキング | NIC/DPUの型番および数量 |
| PCIe | スロットマップ、ライザー、スイッチ、分岐要件 |
| パワー | PSUの種類、冗長性、目標総電力 |
| 冷却 | 気液系、ファンの仕様、ラジエーター/マニホールドの要件 |
| 入出力 | 前面および背面のポートに関する要件 |
| 構造 | GPU固定具、取っ手、レール、補強材 |
| サービス | 工具不要または迅速なアクセスが必要な部品 |
| ブランディング | ロゴ、色、シルクスクリーン、ラベル |
| 制作 | 試作数量、年間生産量、目標スケジュール |
| 市場 | 輸入先国およびコンプライアンス要件 |
入力が完全であればあるほど、機械的な不具合を早期に発見することができます。.
CADで12 mmの干渉を見つけるのは手間がかからない。.
しかし、金型製作、加工、組立、そして国際輸送を経てからそれを見つけるのは、そう簡単ではありません。.
高密度AIシステムでは、機械、熱、電気、設備の各分野の技術が1つの筐体内に集約される必要があります。.
だからこそ、 カスタムAIサーバーシャーシ ラックの高さやGPUの枚数だけで決定すべきではありません。.
まずは完全な部品表から始めましょう。.
熱のモデルを構築する。.
電源用のスペースを確保してください。.
GPUに対応しています。.
ケーブルの配線経路を計画します。.
冷却アーキテクチャは早い段階で決定してください。.
メンテナンスが必要になりやすい部品を中心に、アクセスを設計してください。.
そして、単なる空の筐体ではなく、実際のシステムのプロトタイプを作成してください。.
AIの演算密度は今後も上昇し続けるでしょう。IEAによる高速サーバーの電力消費量の予測や、現在の100kWを超えるラックアーキテクチャは、すでにその傾向を示しています。.
その高密度化にうまく対応できるメーカーやシステムインテグレーターは、単に筐体を小型化するだけの企業ではないだろう。.
何が起きなければならないかを理解するのは、彼らだ ワークロードが100%に達したとき、それらのボックス内部では。.
簡単な答え: カスタムAIサーバーシャーシとは、GPU、CPU、マザーボード、ストレージ、ネットワーク、電源、冷却、およびラックに関する要件の特定の組み合わせに合わせて設計された筐体のことです。.
一般的なサーバーケースとは異なり、その内部レイアウトは、アクセラレータの間隔、構造的サポート、気流、水冷、ケーブル配線、冗長電源、およびメンテナンス時のアクセス性に合わせて最適化することができます。.
簡単な答え: 高密度サーバーシャーシは、限られたラックスペースに大量の演算、ストレージ、またはアクセラレータハードウェアを収容しつつ、適切な電力供給、冷却、構造的サポート、および保守アクセスを確保します。.
密度は、単に構成要素の数だけで判断するのではなく、実用的な持続性能に基づいて評価されるべきである。.
簡単な答え: いいえ。シャーシを小型化すればラック密度を高めることはできますが、5Uや6Uの方が、冷却能力、GPU間の間隔、ケーブル配線、拡張性、およびメンテナンス時のアクセス性の面で優れている場合があります。.
適切なフォームファクタは、GPUの種類、消費電力、冷却方式、マザーボードのレイアウト、および運用要件によって異なります。.
簡単な答え: 熱密度、アクセラレータの出力、ラック密度、騒音制限、または気流の制約により、従来の空冷では効率的な管理が困難になる場合、液体冷却が有力な選択肢となります。.
また、この決定にあたっては、設備用水、CDUの要件、マニホールド、漏水対策、保守手順、および冗長性についても考慮しなければならない。.
簡単な答え: GPU、マザーボード、CPU、PSU、ストレージ、ネットワーク、PCIe、冷却、ラックの寸法、I/O、レール要件、生産数量、およびターゲット市場を明記してください。.
「8 GPU搭載のAIサーバー」といった漠然とした表現よりも、具体的なコンポーネントの図面の方がはるかに有用です。“
簡単な答え: 高性能GPUは、動作中、輸送中、およびメンテナンス中に、PCIeスロット、ブラケット、およびシャーシの構造に機械的な負荷をかける可能性があります。.
適切な固定により、カードの動きを制御し、機械的負荷を分散させ、コネクタや基板の損傷リスクを低減します。.
簡単な答え: 通常はそうではありません。より適切な目標は、熱性能、信頼性の高い電力供給、構造的安定性、および許容可能な保守アクセス性を維持できる、実用上可能な限り高い演算密度です。.
GPUを1枚追加しても、その結果としてシステムがパフォーマンス制限を受けたり、メンテナンスが困難になったりしては意味がありません。.
コメント