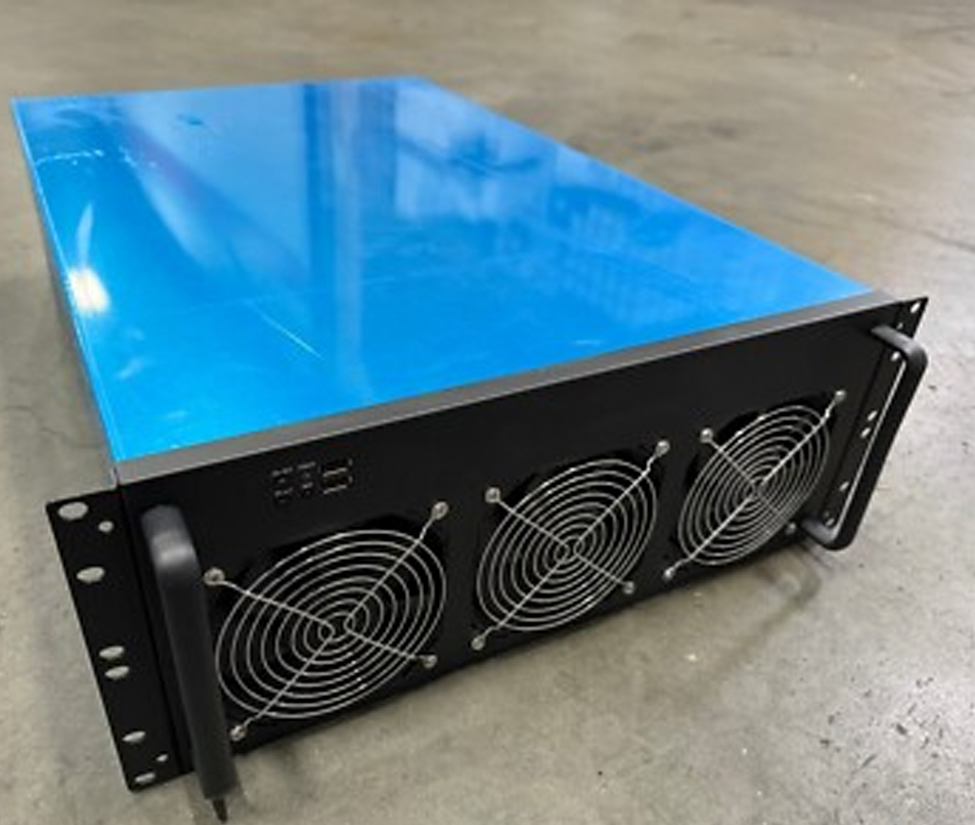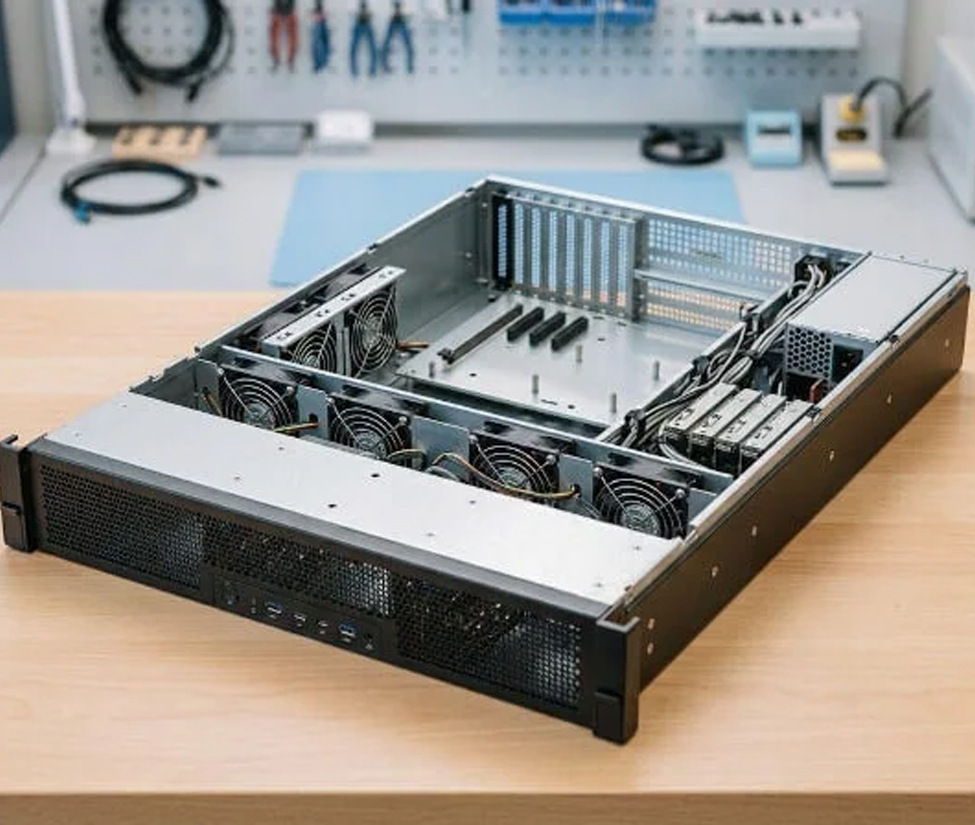
تطبيقات حاويات خوادم GPU لأحمال عمل الذكاء الاصطناعي والحوسبة

يُعد هيكل خادم GPU، الذي يُعرف أيضًا باسم هيكل خادم وحدة معالجة الرسومات، عبارة عن غلاف جاهز للتركيب في حامل، مصمم لدمج وحدات معالجة الرسومات مع وحدة المعالجة المركزية (CPU) واللوحة الأم ووحدات التخزين والشبكات والتبريد ومكونات الطاقة. ويوفر هذا الهيكل الكثافة المطلوبة لوحدات معالجة الرسومات، وتدفق الهواء، وتوزيع الطاقة، وإمكانيات التوسعة، والإعدادات المخصصة لأحمال العمل، وهي العناصر الضرورية لتحقيق حوسبة مُسرَّعة وموثوقة.

تطبيقات حالة خادم وحدة معالجة الرسومات

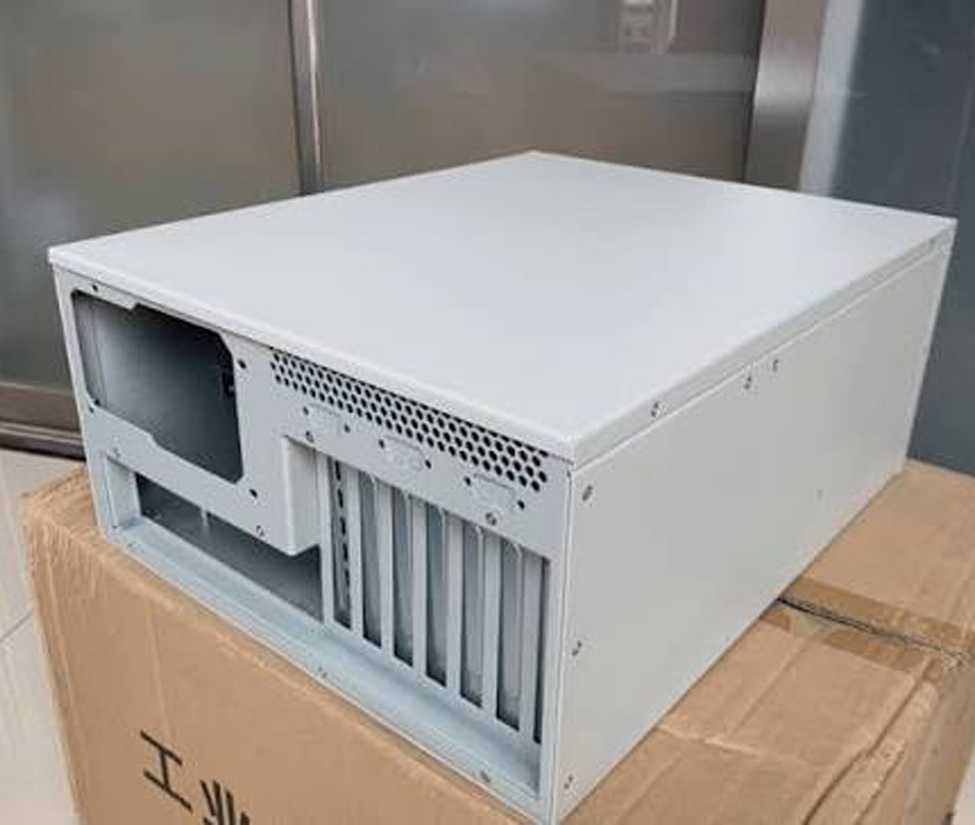
ما هو هيكل وحدة معالجة الرسومات (GPU) المتخصص؟

وهي عبارة عن حاوية متخصصة مصممة لبناء نظام مخصص لمهام الرسومات المعقدة، أو المحاكاة، أو الحوسبة المعجلة، أو الحوسبة عالية الأداء. وعلى عكس حاويات أجهزة الكمبيوتر القياسية أو حاويات الخوادم المخصصة للتركيب على الرفوف ذات الأغراض العامة، يجب أن تراعي هذه الحاوية تدفقًا كبيرًا للهواء، ومسافات فاصلة كافية، وتوزيعًا دقيقًا لوصلات PCIe، وتوزيعًا مستقرًا للطاقة، ودعمًا ميكانيكيًا لبطاقات التسريع الكبيرة.

يقوم الهيكل بتنسيق أبعاد وحدة معالجة الرسومات (GPU)، ومنصة وحدة المعالجة المركزية (CPU)، وتصميم اللوحة، وبنية التوسعة، وحائط المراوح، ومصادر الطاقة، وفتحات التخزين، ومحولات الشبكة. ويُعد الغلاف جزءًا من تصميم النظام، وليس مجرد غلاف معدني.

ما هو حجم الهيكل الأنسب لحجم العمل؟

يحقق الشكل المناسب التوازن بين كثافة الحامل وقدرة التبريد وسهولة الصيانة وإمكانية التوسع واحتياجات التطبيقات. يُعد الهيكل مقاس 1U أو 2U مناسبًا لعمليات النشر المدمجة؛ بينما يوفر التصميم مقاس 4U أو 5U مساحة أكبر للبطاقات كاملة الارتفاع وتدفق الهواء والتخزين وتوصيل الكابلات؛ أما المنصة مقاس 8U أو الأكبر فهي تدعم المُسرِّعات عالية الكثافة والتبريد عالي السعة والطاقة الاحتياطية والصيانة على نطاق البنية التحتية.

لا تتحدد السعة الفعلية لوحدة معالجة الرسومات (GPU) بالارتفاع وحده أبدًا. فهي تعتمد على التخطيط الداخلي، وطول وحدة معالجة الرسومات وعرض الفتحة، وتصميم اللوحة، وتصميم وحدة التوصيل الإضافية، والنظام الحراري، ومصادر الطاقة، وموضع فتحات التوسعة.

تطبيقات حالة خادم وحدة معالجة الرسومات

ما هي الاستخدامات المناسبة لخوادم GPU ذات الحجم 1U و2U؟

عادةً ما تكون خوادم GPU ذات الحجم 1U و2U مناسبة لأحمال العمل التي تكون فيها كثافة الحامل وكفاءة النشر أكثر أهمية من الحصول على أكبر عدد ممكن من وحدات GPU كاملة الحجم. وتشمل التطبيقات النموذجية ما يلي:

يمكن لخادم GPU صغير الحجم توفير معالجة مُسرَّعة بالقرب من المستخدمين أو الكاميرات أو الأجهزة، مع الحفاظ في الوقت نفسه على سعة حامل الخادم. ولا يزال تحديد الحجم النهائي يعتمد على أبعاد وحدة معالجة الرسومات (GPU)، ووضع التبريد، وسعة التخزين، وبيئة الطاقة المتاحة.

لماذا يُستخدم الرقم 4U بشكل شائع في تدريب الذكاء الاصطناعي وعملية العرض؟

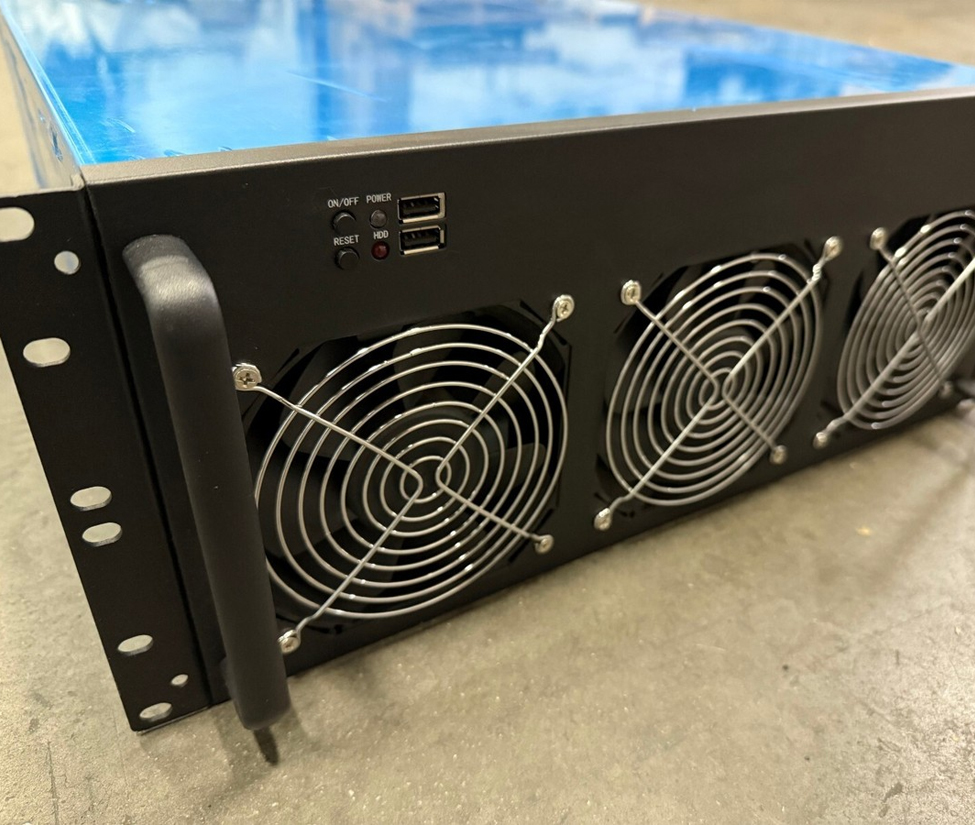
يُستخدم الهيكل من فئة 4U على نطاق واسع في الأنظمة عالية الأداء المزودة بوحدات معالجة رسومات متعددة (GPU)، لأنه يوفر مساحة عملية لمُسرعات الأداء والمراوح وتوجيه منافذ PCIe ووحدات التخزين والوصول لأغراض الصيانة. وتشمل التطبيقات الشائعة لهيكل 4U تدريب الذكاء الاصطناعي، وتطوير نماذج اللغة الكبيرة (LLM) والذكاء الاصطناعي التوليدي، والتعلم العميق، والعرض ثلاثي الأبعاد، والرسوم المتحركة، والتصور المعماري، والمحاكاة العلمية، والنمذجة المالية، ومعالجة البيانات الضخمة، والحوسبة عالية الأداء (HPC) السائدة.

يمكن لبعض المنصات ذات الحجم 4U المصممة بشكل سليم استيعاب ما يصل إلى ثماني وحدات معالجة رسومات (GPU) كاملة الحجم، اعتمادًا على المنصة وتصميم نظام التبريد وتخطيط اللوحة ونوع وحدة معالجة الرسومات. وتُظهر التصميمات الحالية لخوادم 4U المثبتة على حاملات الرف نطاقًا يتراوح بين بطاقات التوصيل المباشر واللوحات الأساسية من فئة HGX.

لا تعتبر حاوية 4U مناسبة تلقائيًا لجميع بطاقات الرسومات. لذا، يجب التحقق من ضغط المروحة، ودرجة حرارة الهواء الداخل، والمسافة بين البطاقات، وكابلات الطاقة، ومسارات الكابلات، ونظام التبريد (سواء كان نشطًا أم سلبيًا).

تطبيقات حالة خادم وحدة معالجة الرسومات

متى يكون استخدام أنظمة GPU ذات سعة 8U أو أكبر خيارًا مناسبًا؟

يُعد استخدام أنظمة وحدة معالجة الرسومات (GPU) بحجم 8U أو أكبر خيارًا منطقيًّا عندما تكون أولوية كثافة المسرعات، وقدرة التبريد، والتكرار، والاتصال بين وحدات GPU، وسهولة الصيانة، أكبر من كفاءة استخدام مساحة الحامل. تستخدم الشركات والجامعات ومؤسسات البحث والمختبرات الوطنية ومشغلي مراكز البيانات ومزودي البنية التحتية للذكاء الاصطناعي هذه المنصات من أجل مجموعات الذكاء الاصطناعي التوليدي، وتطوير النماذج الأساسية، والحوسبة الفائقة للمؤسسات، والحوسبة العلمية، والبنية التحتية لوحدات معالجة الرسومات متعددة العقد، والمسرعات المؤسسية عالية الكثافة، وغيرها من عمليات النشر التي تتطلب موارد كبيرة.

تجمع منصات فئة HGX بين وحدات معالجة رسومات (GPU) متعددة ووصلات داخلية عالية السرعة من أجل أعباء عمل الذكاء الاصطناعي القابلة للتوسع والحوسبة المعجلة. كما توفر الأنظمة الأكبر حجمًا مساحة لأجهزة التبريد والشبكات والتخزين ومصدر طاقة احتياطي؛ وتُظهر المنصات التجارية ذات الحجم 8U تكاملًا مع إمكانيات توسعة واسعة وفتحات متعددة لمحركات الأقراص مقاس 2.5 بوصة.

ما هي حالات استخدام خوادم GPU التي تتناسب مع كل حجم من أحجام الهياكل؟

بالنسبة للمشترين الذين يقارنون بين خوادم GPU المخصصة للذكاء الاصطناعي، تُعد هذه العلاقات نقاط انطلاق مفيدة، وليست حدودًا عامة:

التطبيق الحجم الشائع للهيكل الأولوية الرئيسية في التصميم
VDI، الألعاب السحابية، الرسومات عن بُعد 1U أو 2U كثافة الرفوف والنشر الفعال
الاستدلال على الحافة، تحليل الفيديو، معالجة بيانات أجهزة الاستشعار 1U أو 2U الحوسبة المحلية، تدفق الهواء، التكامل المدمج
تدريب نماذج الذكاء الاصطناعي، والتصوير الحاسوبي، والحوسبة عالية الأداء في المجال العام 4U قدرات بطاقات الرسومات المتعددة، والتبريد، والتوسعة
مجموعات كبيرة من أنظمة الذكاء الاصطناعي التوليدي، والحوسبة الفائقة 8U أو أكبر كثافة المسرعات، والوصلات البينية، والتكرار

كيف ينبغي تقييم هيكل وحدة معالجة الرسومات (GPU)؟

قم بتقييم الهيكل كجزء من نظام وحدة معالجة الرسومات (GPU) الكامل. تأكد من العوامل التالية قبل الشراء:

تطبيقات حالة خادم وحدة معالجة الرسومات

ما هي القضبان التوجيهية للهيكل؟

ما الغرض من استخدام حافظة خادم GPU؟

تضم حاوية خادم GPU وحدة معالجة رسومات واحدة أو أكثر إلى جانب وحدة المعالجة المركزية (CPU) واللوحة الأم ووحدات التخزين والشبكات والتبريد ومكونات الطاقة اللازمة لأحمال العمل المعجلة. وبالمقارنة مع حاوية الخادم ذات الأغراض العامة، فإنها مصممة بحيث تراعي المساحة المطلوبة لوحدات معالجة الرسومات (GPU)، وإنتاج الحرارة المركّز، واتصالات PCIe، وتوزيع الطاقة، والوصول لأغراض الصيانة. وتشمل التطبيقات النموذجية تدريب الذكاء الاصطناعي، واستدلال الذكاء الاصطناعي، وعملية العرض، ومحطات العمل الافتراضية، وتحليلات الفيديو، والحوسبة العلمية، والحوسبة عالية الأداء (HPC).

Choose the form factor according to the workload, GPU dimensions, cooling requirements, expansion needs, and available rack space. A 1U or 2U chassis is commonly used for compact inference, VDI, video analytics, or remote graphics deployments. A 4U platform is often selected for multi-GPU AI training, rendering, and mainstream HPC, while 8U and larger systems are generally considered for dense accelerator platforms and infrastructure-scale AI clusters. These are guidelines rather than fixed limits; current server portfolios include 4U, 5U, 8U, and 10U designs for different AI and HPC architectures.

Some 4U systems support up to eight GPUs, but this capability depends on the specific platform, GPU type, PCIe topology, motherboard layout, thermal design, and power system. For example, current Supermicro 4U platforms include configurations designed for up to eight direct-connect PCIe GPUs, but that specification should not be applied to every 4U chassis. Always verify the complete system configuration rather than relying on rack height alone.

Confirm the GPU length, height, slot width, cooling method, and power requirements first. Then review PCIe generation and lane allocation, riser design, CPU and motherboard compatibility, fan capacity, airflow direction, power connectors, redundant power options, storage bays, rack depth, cable routing, and maintenance access. Manufacturer qualification is especially useful because it evaluates thermal, mechanical, power, and signal-integrity requirements together.

An HGX-class platform is more appropriate when the workload requires a tightly integrated multi-GPU architecture, high-speed GPU-to-GPU communication, enterprise networking, and scale-up AI or HPC capability. NVIDIA describes HGX as a platform combining GPUs, NVLink, networking, and optimized software, so it differs from a conventional chassis populated with independent PCIe graphics cards. The correct choice depends on model size, communication patterns, cluster design, cooling infrastructure, power availability, and budget.

Configure the Right GPU Chassis for Your Workload

The right chassis protects the value of the entire GPU server by aligning accelerator fit, connectivity, cooling, power, storage, and service access with the intended application.

Share your preferred GPUs, GPU quantity, motherboard model, CPU platform, storage requirements, rack-space limits, cooling requirements, power environment, and intended AI, rendering, inference, or high-performance compute workload.